


ปัญหาของ AI Agent ในโปรเจกต์จริงมักไม่ได้เริ่มจาก Model ไม่เก่ง แต่เริ่มจากความรู้ของโปรเจกต์กระจัดกระจาย ข้อสรุปอยู่ในประวัติแชต กติกาอยู่หลายไฟล์ และ automation ถูกเขียนเป็น prompt โดยไม่มีใครยืนยันว่าถูกติดตั้งจริง เมื่อเปลี่ยน Agent หรือกลับมาทำงานหลังผ่านไปหลายวัน ระบบจึงต้องค้นเอกสารและตีความเรื่องเดิมใหม่
LLM Wiki เป็นแนวคิดที่ช่วยเปลี่ยนข้อมูลดิบให้กลายเป็นความรู้แบบสะสม โดยยังย้อนกลับไปหาหลักฐานต้นทางได้ แต่การมี wiki อย่างเดียวไม่พอ หากต้องการให้ AI Agent ทำงานกับ codebase ได้อย่างปลอดภัย เราต้องออกแบบ provider adapters, project control, product runtime และพื้นที่ข้อมูลที่สร้างใหม่ได้ให้แยกจากกันด้วย
บทความนี้อธิบายทั้งแนวคิด LLM Wiki จากต้นฉบับของ Andrej Karpathy และโครงสร้าง Agent Project Starter ที่ผ่าน deep audit จากไฟล์จริง รวมถึงตอบคำถามสำคัญว่า framework นี้ถูกติดตั้งอย่างไร ทำไมไม่ควร clone ทั้ง repository และจะย้ายโปรเจกต์เดิมอย่างไรโดยไม่รบกวนงานที่กำลังรัน
สารบัญเนื้อหา
แสดง
LLM Wiki คืออะไร และต่างจาก RAG อย่างไร
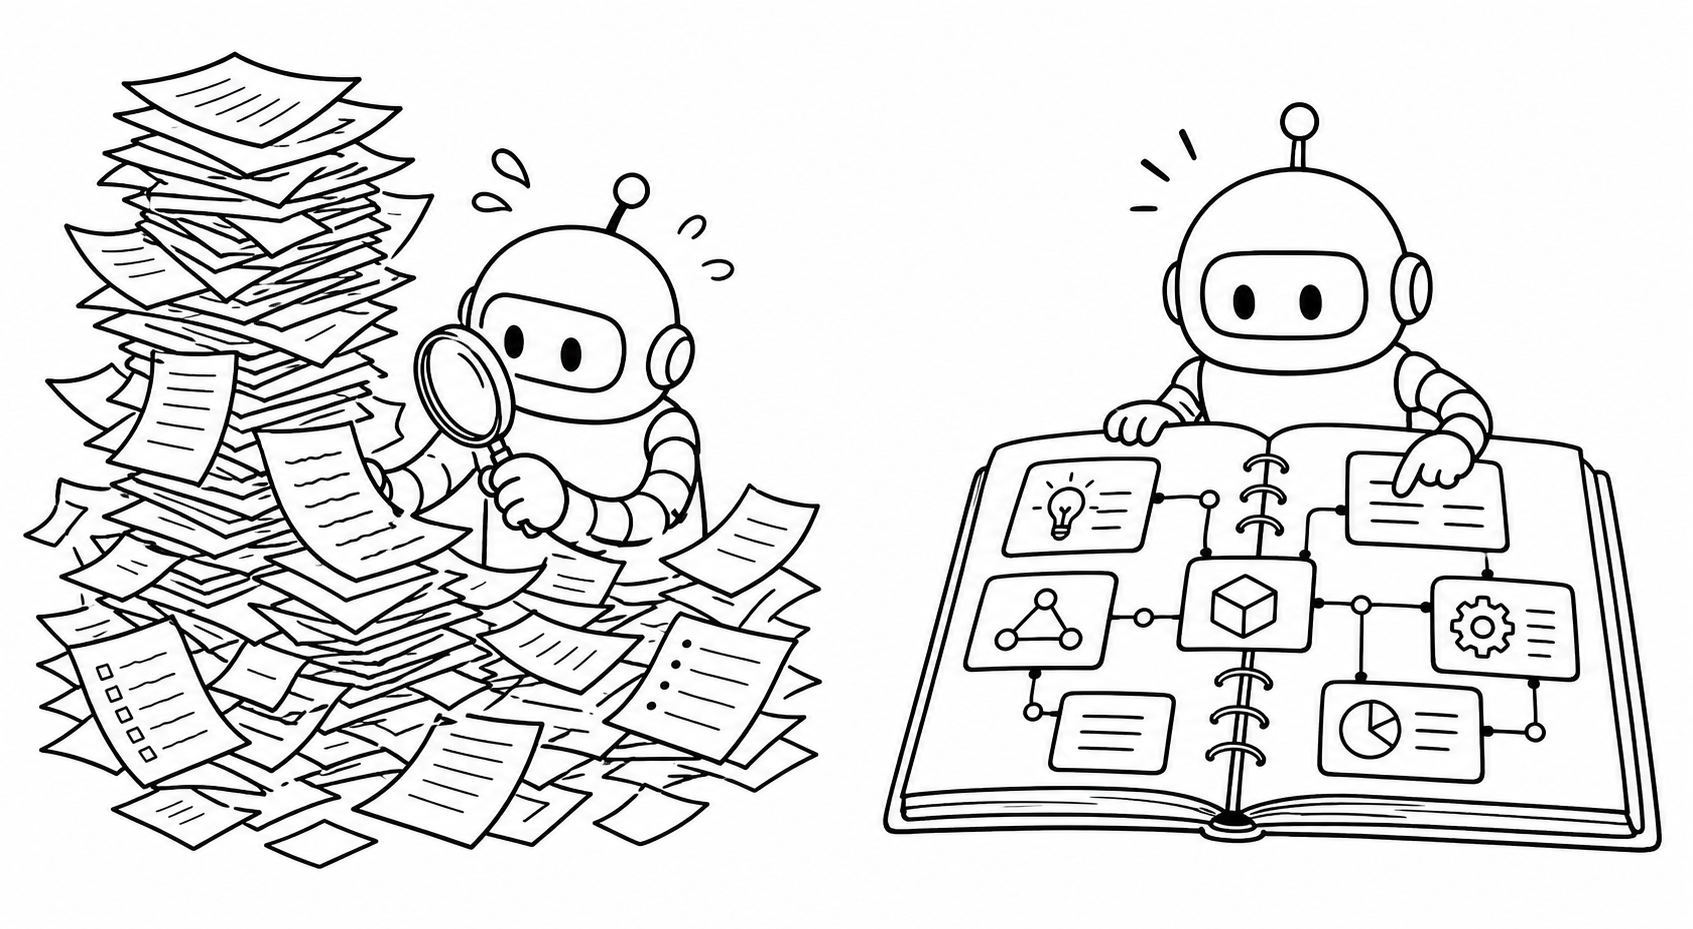
RAG มักค้นส่วนของเอกสารที่เกี่ยวข้องตอนมีคำถาม แล้วส่งบริบทนั้นให้ Model สร้างคำตอบ วิธีนี้มีประโยชน์มาก แต่คำถามครั้งถัดไปอาจต้องค้นและสังเคราะห์เรื่องเดิมอีกครั้ง โดยเฉพาะคำถามที่ต้องเชื่อมข้อมูลจากหลายแหล่ง
LLM Wiki เพิ่มชั้นความรู้ที่ถูกดูแลระหว่างผู้ใช้กับหลักฐานดิบ เมื่อรับ source ใหม่ ระบบไม่ได้เพียงเก็บไฟล์ แต่จัดทำ catalog, สร้างหรือปรับ maintained page, เชื่อมความสัมพันธ์ และบันทึกสิ่งที่ยังขัดแย้งกันไว้ การค้นคว้าครั้งใหม่จึงต่อยอดจากความเข้าใจที่มีอยู่ แทนการเริ่มจากศูนย์
จุดสำคัญคือ wiki ไม่ได้แทนที่ source ข้อสรุปที่มีผลต่อการตัดสินใจต้องย้อนกลับไปยังหลักฐานได้ และ raw source ไม่ควรถูก Model แก้ทับเพื่อให้เรื่องราวดูสอดคล้องกัน
สามชั้นและห้าปฏิบัติการของ LLM Wiki
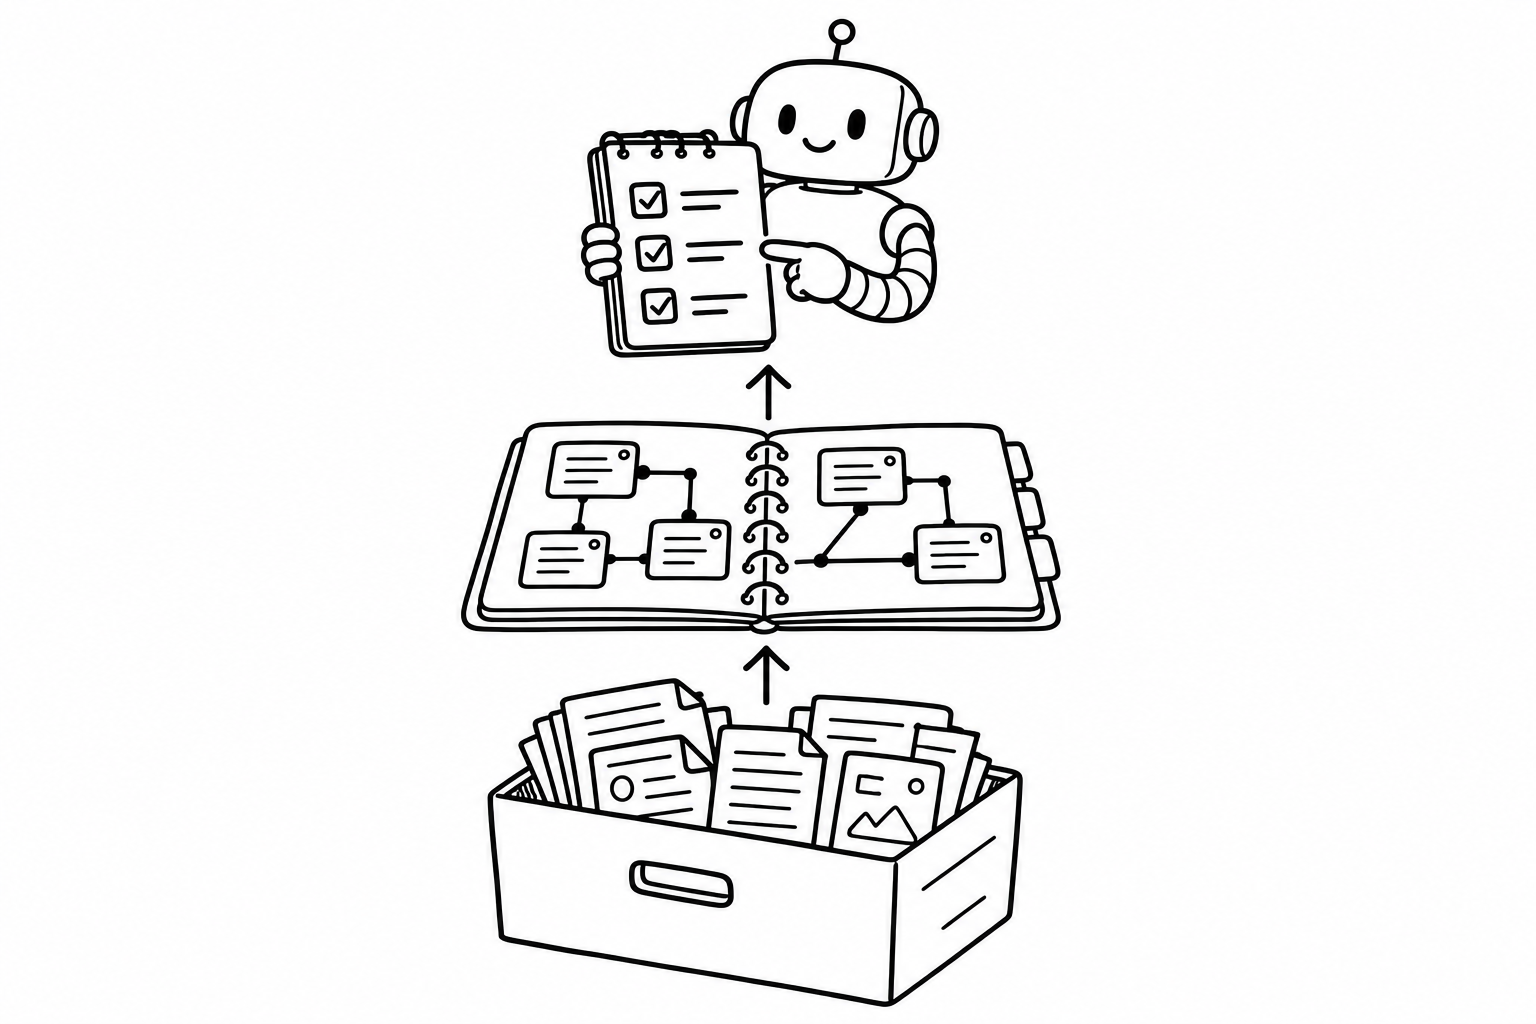
ต้นฉบับ LLM Wiki ระบุสถาปัตยกรรมหลักไว้สามชั้น และเสนอการทำงานแบบ ingest, query, lint, index และ log โดยเปิดให้ผู้นำไปใช้เลือกโครงสร้างไฟล์จริงเอง
| ชั้น | หน้าที่ | กติกาหลัก |
|---|---|---|
| Raw sources | เก็บเอกสาร รูปภาพ ข้อมูล URL หรือหลักฐานต้นทาง | คงสภาพเดิมและไม่ถูก LLM แก้ไข |
| Maintained wiki | สรุปแนวคิด บุคคล ระบบ การเปรียบเทียบ และข้อขัดแย้ง | ทุก claim สำคัญต้องอ้าง source ID |
| Schema หรือ rulebook | กำหนดรูปแบบข้อมูล การเชื่อมโยง และวิธีดูแล wiki | Agent ต้องอ่านและ lint ตามกติกาเดียวกัน |
ห้าปฏิบัติการทำให้สามชั้นนี้ไม่กลายเป็นกอง Markdown ที่ไม่มีเจ้าของ
- Ingest รับ source จาก inbox, ให้ ID, บันทึก provenance และสร้าง immutable record
- Query เริ่มจาก maintained page แล้วค่อยเปิด record เมื่อจำเป็น พร้อมคืน source ID
- Lint ตรวจ schema, record, link, source reference, contradiction และความล้าสมัย
- Index จัดทางเข้าตามหัวข้อและคำถามของผู้อ่าน ไม่ใช่เรียงตามวันที่อย่างเดียว
- Log บันทึกเหตุการณ์ ingest, query, lint และ synthesis ตามลำดับเวลา
สิ่งที่ต้องแยกให้ชัดคือ lifecycle ของโปรเจกต์, npm commands และนโยบาย cleanup เป็น local decisions ไม่ใช่ข้อกำหนดจาก Karpathy การอ้าง LLM Wiki ให้ local policy ทั้งหมดทำให้ provenance ผิด แม้แนวคิดโดยรวมจะได้รับแรงบันดาลใจจาก source เดียวกันก็ตาม
ทำไม starter แบบ copy ทั้งโฟลเดอร์จึงมีความเสี่ยง
starter รุ่นแรกดูสมเหตุสมผลจากภายนอก เพราะมี AGENTS.md, provider folders, wiki, scripts และ tests แต่ deep audit พบว่าการตรวจแบบเช็กเพียงชื่อไฟล์ทำให้ได้ผลสีเขียวที่ไม่รับประกันความปลอดภัย
ตัวอย่างปัญหาที่พิสูจน์ได้ในพื้นที่ทดสอบ ได้แก่ cleanup ตาม junction ออกไปลบไฟล์นอก workspace, generator คัดลอก .env ที่ไม่อยู่ในรายการ, link ไปยัง secret ภายนอกถูกอ่านตามปลายทาง, root ผิดยังเริ่ม mutation ได้ และ project ที่ generate แล้วมี generator ซ้อนอยู่ภายในอีกชั้น
บทเรียนไม่ใช่ว่า automation ใช้ไม่ได้ แต่คือทั้ง generator และ maintenance ต้อง fail closed หากตรวจ root, sentinel, containment หรือชนิดไฟล์ไม่ได้ ระบบต้องหยุดก่อน mutation เสมอ
framework กับ generated project เป็นคนละโครงสร้าง
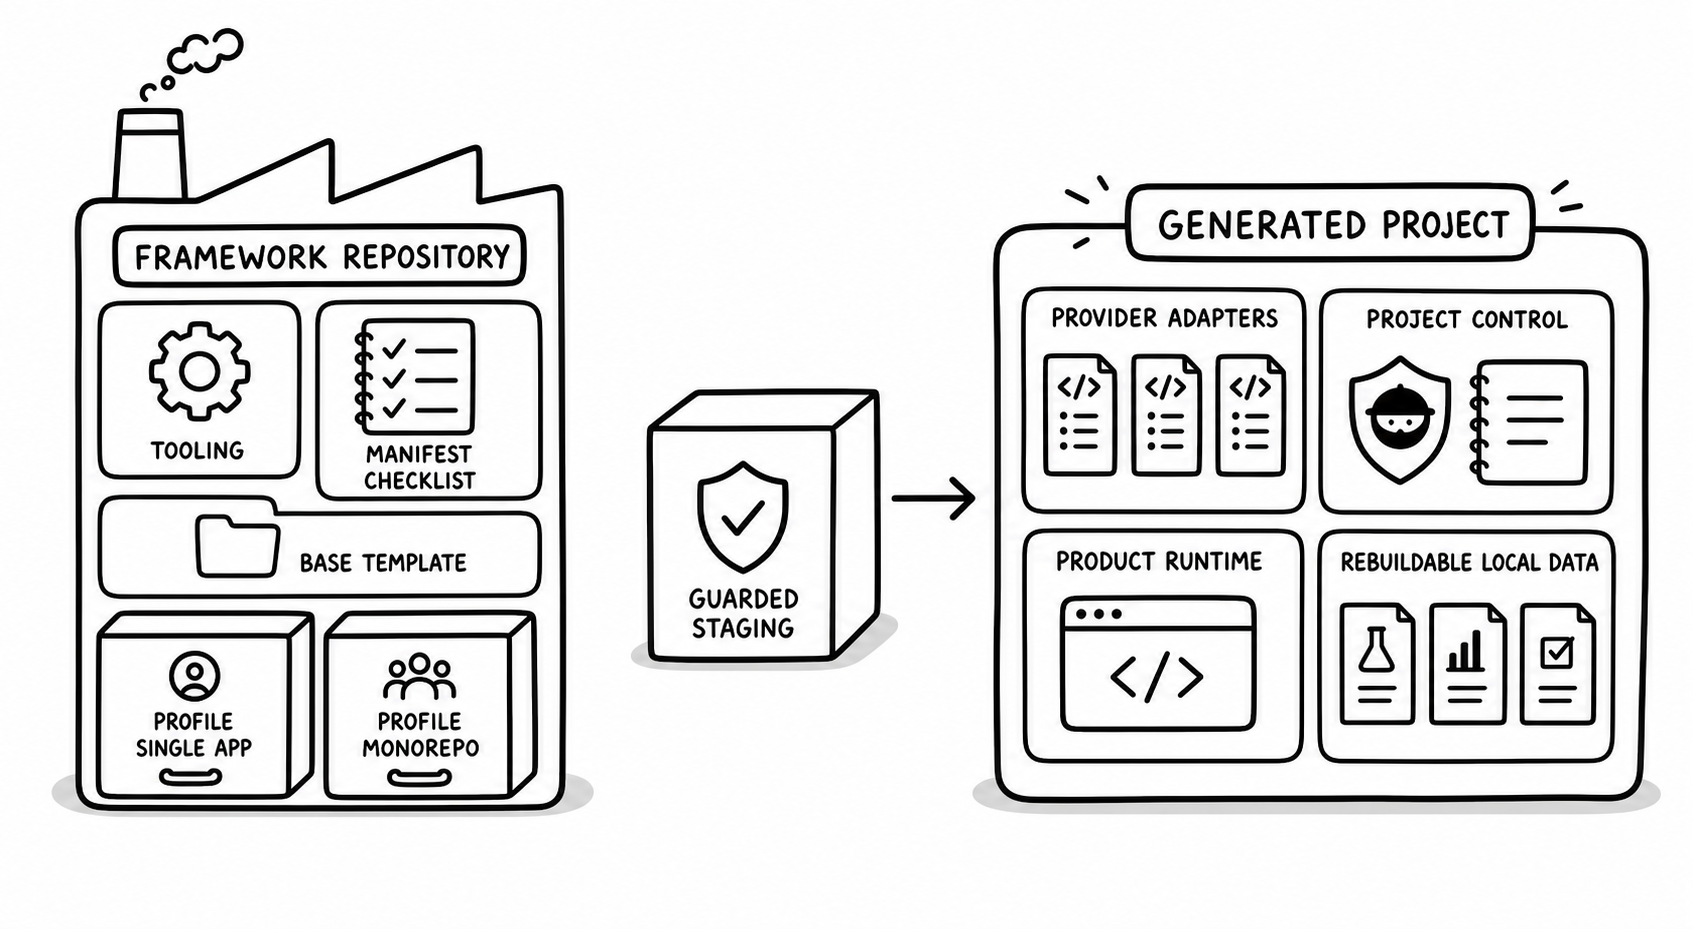
Agent Project Starter รุ่นใหม่เป็น framework สำหรับสร้างโปรเจกต์ ไม่ใช่โฟลเดอร์ที่นำไป copy ทั้งก้อน repository ต้นทางมี generator และ template ส่วนโปรเจกต์ปลายทางได้รับเพียง payload ที่ระบุใน manifest และ runtime profile ที่เลือก
โครงสร้าง framework จริงเป็นดังนี้
agent-project-starter/
├── AGENTS.md
├── CLAUDE.md
├── GEMINI.md
├── README.md
├── package.json
├── docs/
│   ├── architecture/
│   ├── audits/
│   └── migrations/
├── tooling/
│   ├── create-project.mjs
│   ├── verify-template.mjs
│   ├── lib/
│   │   └── fs-safety.mjs
│   └── tests/
│       └── starter.test.mjs
└── template/
    ├── manifest.json
    ├── base/
    │   ├── provider adapters
    │   ├── project-control.json
    │   ├── docs/
    │   └── tools/project-control/
    └── profiles/
        ├── single-app/
        │   ├── src/
        │   └── tests/
        └── monorepo/
            ├── apps/
            ├── packages/
            └── tests/
tooling/ ใช้ดูแล framework เท่านั้น จึงไม่ควรหลุดเข้าโปรเจกต์ใหม่ template/base/ คือ control plane กลาง ส่วน template/profiles/ กำหนด shape ของ product runtime
การเลือก profile สำคัญกว่าการสร้างทุกโฟลเดอร์ไว้เผื่อ หากเป็นแอปเดียวให้เลือก single-app และใช้ src/ หากเป็นหลายแอปกับ shared packages ให้เลือก monorepo แล้วใช้ apps/ กับ packages/ การสร้างทั้งสองแบบพร้อมกันทำให้ Agent ไม่รู้ว่า runtime root ที่แท้จริงอยู่ที่ไหน
เวลา install หรือสร้างโปรเจกต์เกิดอะไรขึ้น
คำสั่งสร้างโปรเจกต์ไม่ได้ clone Git และไม่ได้ไล่ copy ไฟล์จาก root ทั้งหมด
node tooling/create-project.mjs `
  "F:\AI Project\workspace\a-queue\my-project" `
  --name "My Project" `
  --profile single-app
ลำดับทำงานจริงมีดังนี้
- อ่าน
template/manifest.jsonเพื่อเลือกเฉพาะbaseและ profile เดียว - ตรวจว่า target ยังไม่มีอยู่ เพื่อไม่ merge กับงานเดิมโดยไม่ตั้งใจ
- ปฏิเสธ symlink, junction และ entry ที่ไม่ใช่ regular file หรือ directory
- สร้าง staging directory ข้าง target
- copy เฉพาะ allowlisted template layers และแทนค่า project name กับ package name
- รัน provider check, knowledge lint, Markdown link check และ sentinel validation ใน staging
- rename staging เป็น target เมื่อทุก check ผ่านเท่านั้น
- หากมีข้อผิดพลาด ให้ลบเฉพาะ staging ที่ generator เป็นเจ้าของและไม่ทิ้ง partial target
ชื่อโปรเจกต์ภาษาไทยใช้ได้ แต่ npm package name ต้องเป็น ASCII ที่ถูกต้อง หาก derive ไม่ได้ generator จะขอ --package-name อย่างชัดเจน แทนการเปลี่ยนเป็นชื่อทั่วไปที่อาจชนกับโปรเจกต์อื่น
โครงสร้างโปรเจกต์ที่ generate แล้วมีสี่ plane
โปรเจกต์ single-app ที่ได้จาก framework จะมีหน้าตาประมาณนี้
my-project/
├── AGENTS.md
├── CLAUDE.md
├── GEMINI.md
├── README.md
├── package.json
├── project-control.json
├── .agents/
│   ├── rules/
│   └── skills/
├── .claude/
│   ├── rules/
│   └── skills/
├── docs/
│   ├── README.md
│   ├── architecture/
│   ├── knowledge/
│   │   ├── index.md
│   │   ├── schema.md
│   │   ├── log.md
│   │   ├── pages/
│   │   └── sources/
│   │       ├── catalog.md
│   │       ├── inbox/
│   │       └── records/
│   └── operations/
│       ├── lifecycle.md
│       ├── maintenance.md
│       ├── changelog.md
│       ├── backlog.md
│       ├── release.md
│       └── automation/
├── tools/
│   └── project-control/
│       ├── config.mjs
│       ├── maintenance.mjs
│       ├── verify-agent-surfaces.mjs
│       ├── knowledge-lint.mjs
│       └── verify.mjs
├── src/
└── tests/
สี่ plane มีเจ้าของต่างกัน
| Plane | สิ่งที่อยู่ภายใน | หลักการ |
|---|---|---|
| Provider adapters | root instruction files และ dot folders ของ provider | บางและชี้กลับไป canonical contract |
| Project control | sentinel, docs และ control CLI | ตรวจโครงสร้างและกติกาแบบ deterministic |
| Product runtime | src/ หรือ apps/ กับ packages/, product tests, infra |
เป็นงานจริงของโปรเจกต์ ไม่ถูก starter maintenance จัดระเบียบเอง |
| Generated local data | เฉพาะ root ที่ประกาศว่าสร้างใหม่ได้ | ลบได้หลังผ่าน preflight เท่านั้น |
root scripts/ ถูกสงวนไว้ให้ product runtime หากแอปต้องมีคำสั่ง deploy, import หรือ build ส่วนคำสั่งจัดการโครงสร้างกลางอยู่ที่ tools/project-control/ จึงไม่ปะปนว่า script ใดเป็นของโปรแกรมและ script ใดเป็นของระบบดูแลโปรเจกต์
AGENTS.md ใช้ร่วมกันได้อย่างไรโดยไม่หลอก provider
AGENTS.md เป็น canonical contract ที่ดี แต่ไม่ได้หมายความว่าทุก provider จะโหลดไฟล์นี้แบบ native เหมือนกัน
| Provider | ไฟล์ที่อ่านตามเอกสาร | วิธีเชื่อมกับ contract กลาง |
|---|---|---|
| Codex | AGENTS.md และ .agents/skills/ |
อ่านโดยตรง |
| Claude Code | CLAUDE.md, .claude/rules/, .claude/skills/ |
ให้ CLAUDE.md import @AGENTS.md |
| Gemini CLI | GEMINI.md และ skill path ที่รองรับ |
ให้ GEMINI.md import @AGENTS.md หรือกำหนด context filename |
| Antigravity | AGENTS.md, GEMINI.md, .agents/rules/, .agents/skills/ |
ใช้ root context และ workspace customization |
ไฟล์ Claude ที่เหมาะกับ Windows จึงบางมาก
@AGENTS.md

## Claude Code Adapter

Claude-native project skills live in `.claude/skills/`.
Shared procedures remain in `AGENTS.md` and `docs/`.
Claude Code ระบุชัดว่าอ่าน CLAUDE.md ไม่ใช่ AGENTS.md โดยตรง และแนะนำการ import @AGENTS.md บน Windows ส่วน project skills ของ Claude อยู่ใน .claude/skills/<skill-name>/SKILL.md ดังนั้น .agents/skills/ อย่างเดียวไม่ใช่ cross-provider ที่ครบถ้วน
วิธีที่ปลอดภัยคือมี source skill กลางใน .agents/skills/, สร้าง mirror สำหรับ .claude/skills/ และให้ validator ตรวจว่าเนื้อหาตรงกันทุก byte หากไม่ต้องใช้ provider-specific setting ก็ไม่ควรสร้าง .codex/, .gemini/ หรือ .antigravity/ เปล่าไว้เพื่อให้ tree ดูครบ
project-control.json คือ boundary ก่อน mutation
sentinel ไม่ได้เป็นเพียง metadata แต่เป็นสัญญาว่า project root นี้มี profile ใด อะไรคือ runtime อะไรต้องป้องกัน และอะไรสร้างใหม่ได้
{
  "schemaVersion": 1,
  "profile": "single-app",
  "runtimeRoots": ["src"],
  "testRoots": ["tests"],
  "controlRoots": ["docs", ".agents", ".claude", "tools/project-control"],
  "protectedRoots": [
    "AGENTS.md",
    "CLAUDE.md",
    "GEMINI.md",
    ".agents",
    ".claude",
    "docs",
    "tools/project-control",
    "src",
    "tests"
  ],
  "generatedRoots": ["coverage", "test-results", "playwright-report"]
}
mutation ต้องหยุดหาก sentinel หาย, เป็น directory, เป็น link, parse ไม่ได้ หรือ required controls ไม่ใช่ regular files การมี filename ถูกต้องแต่ชนิดผิดจึงไม่ถือว่าผ่าน
Maintenance ที่ปลอดภัยต้อง fail closed
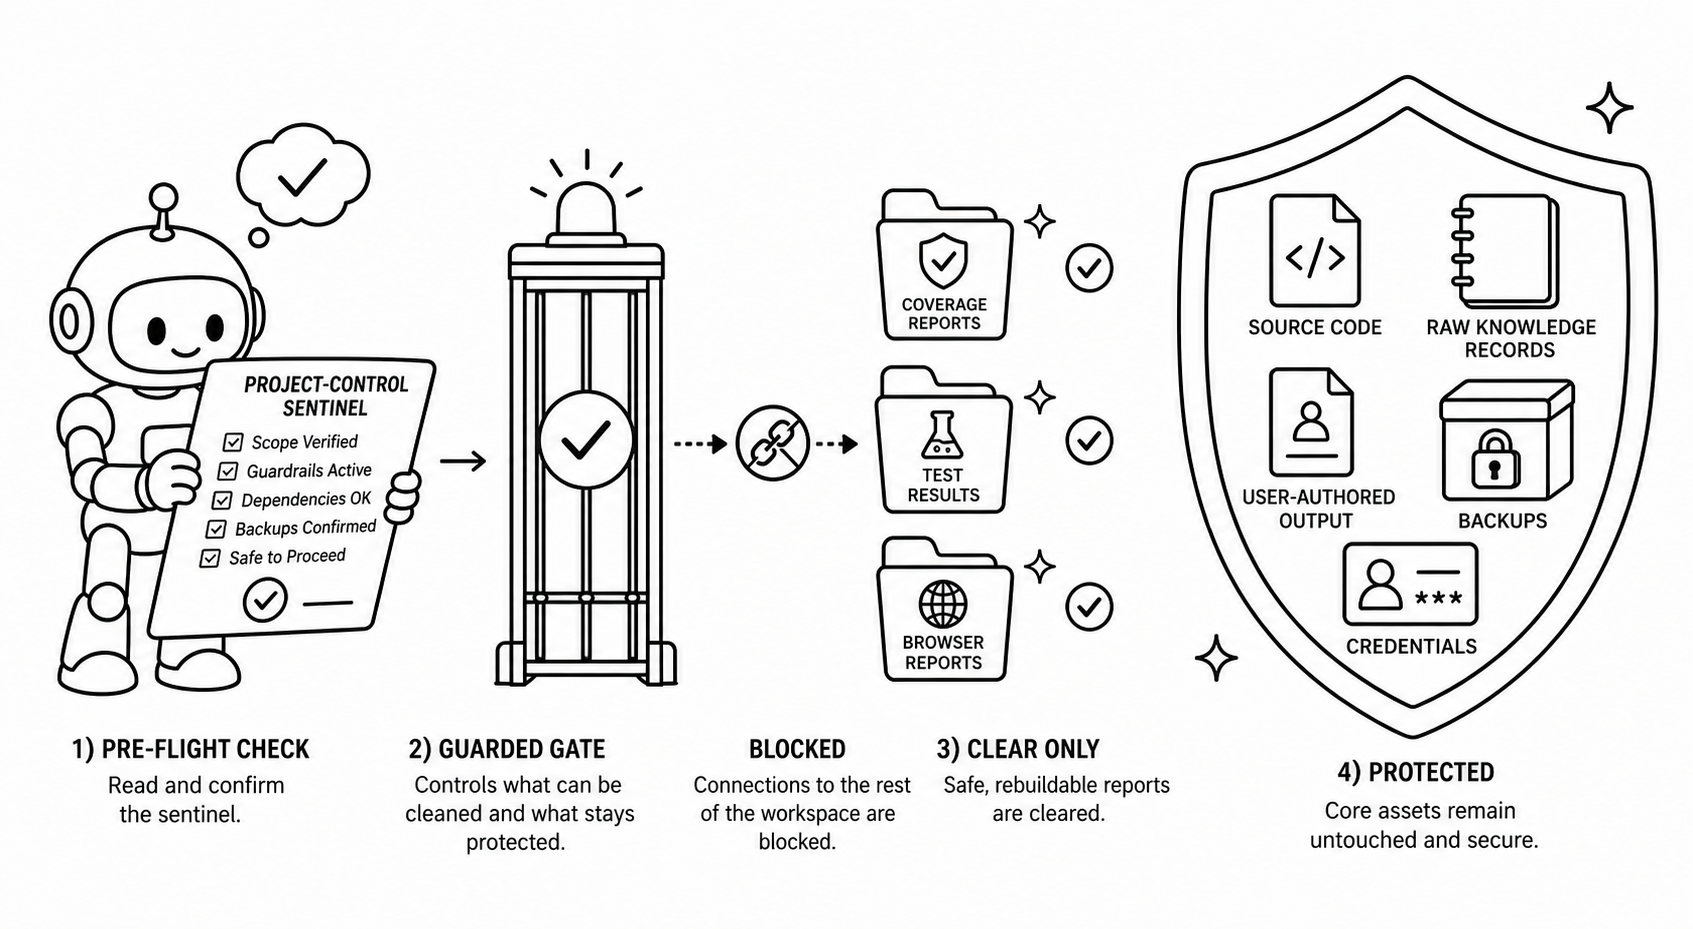
automation ไม่ควรลบทุกอย่างที่ชื่อเหมือน cache เพราะชื่อเดียวกันอาจมีความหมายต่างกันในแต่ละโปรเจกต์ รุ่นที่ปรับแล้วให้ auto cleanup ได้เฉพาะ coverage/, test-results/ และ playwright-report/ ที่อยู่ตรง project root และถูกประกาศใน sentinel
ก่อนลบต้องตรวจทุก target ให้ครบก่อน mutation แรก
- root ต้องมี sentinel ที่ถูกต้อง
- path ต้องเป็น child ของ real project root
- generated root ต้องเป็น directory จริง ไม่ใช่ link หรือ junction
- ทุก entry ภายในต้องไม่ resolve ออกนอก workspace
- target ต้องอยู่ใน allowlist แบบ exact match
node_modules/, .venv/, .next/, dist/ และ .cache/ อาจสร้างใหม่ได้ในทางเทคนิค แต่มีต้นทุนและผลต่อ runtime จึงควรอยู่ใน deep-clean ที่ผู้ใช้อนุมัติ ไม่ใช่ daily automation ส่วน backups, exports, uploads และ human outputs ต้องถือเป็นข้อมูลผู้ใช้ ไม่ใช่ generated junk
วงจรทำงานของ Agent ที่มีขอบเขตชัดเจน
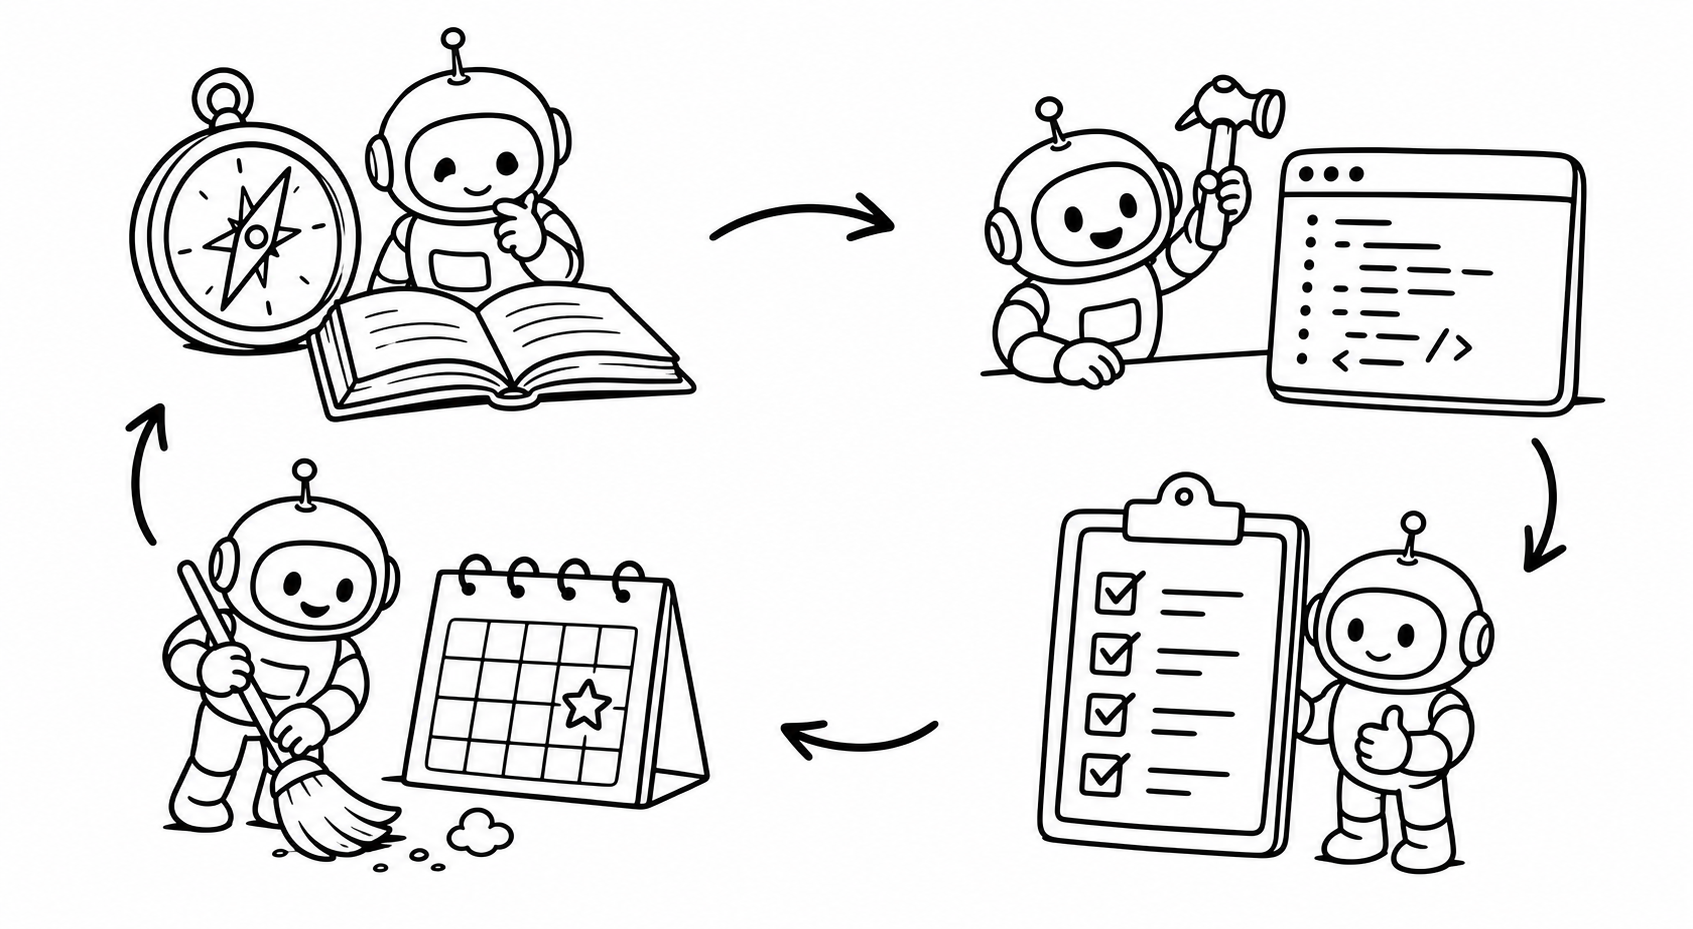
self-management ที่ดีไม่ใช่ cleanup loop ที่ทำงานไปเรื่อย ๆ แต่เป็นการตรวจตาม boundary
- Pre-task context check ยืนยัน root, อ่าน sentinel กับ docs และบันทึก Git status เริ่มต้น
- Milestone checkpoint audit หลังเปลี่ยน architecture, provider adapter, public contract หรือนโยบายข้อมูล
- Task closeout gate รัน project-control check แล้วตามด้วย product tests ที่เกี่ยวข้อง
- Scheduled maintenance ทำหน้าที่เป็น safety net และหยุดที่ audit-only เมื่อ worktree dirty
คำสั่งพื้นฐานใน generated project จึงสั้นและมีเจ้าของชัด
npm run workspace:audit
npm run knowledge:lint
npm run providers:verify
npm run check
workspace:fix ใช้เมื่อ audit พบ exact declared generated root และผู้ดำเนินงานยืนยันว่าข้อมูลนั้นทิ้งได้ ไม่ควรรัน cleanup ซ้ำหลัง test เพียงเพื่อให้รายงานดูสะอาด
Knowledge กับ operations ต้องแยก log คนละเรื่อง
docs/knowledge/ รับผิดชอบหลักฐานและความเข้าใจที่สังเคราะห์แล้ว ส่วน docs/operations/ รับผิดชอบวิธีทำงานและประวัติการเปลี่ยน control plane
docs/
├── knowledge/
│   ├── index.md
│   ├── schema.md
│   ├── log.md
│   ├── pages/
│   └── sources/
│       ├── catalog.md
│       ├── inbox/
│       └── records/
└── operations/
    ├── lifecycle.md
    ├── maintenance.md
    ├── changelog.md
    ├── backlog.md
    ├── release.md
    └── automation/
knowledge log ใช้กับ ingest, query, lint และ synthesis ส่วน operations changelog ใช้กับ maintenance, provider adapter, automation และ release การย้ายไฟล์ provider จึงไม่ควรถูกบันทึกเหมือนเป็น source ingest
สำหรับ web source ที่เปลี่ยนได้ catalog ควรมี author, accessed date, last verified, mutability, revision หรือ checksum, record path และ status ตัวอย่าง LLM Wiki ใน starter ใช้ pointer record ที่ pin revision ac46de1ad27f92b28ac95459c782c07f6b8c964a โดยไม่ copy เนื้อหาทั้งหมดเกินความจำเป็น
prompt สำหรับ automation ยังไม่ใช่ automation ที่ติดตั้งแล้ว
ไฟล์ docs/operations/automation/daily-maintenance.prompt.md คือ contract สำหรับ scheduler ไม่ใช่ scheduler เอง การมีข้อความว่าให้รันทุกวันไม่ได้สร้าง job, credential, memory หรือสิทธิ์ commit ให้ระบบ
automation ที่ปลอดภัยต้องแยกความรับผิดชอบดังนี้
- repository กำหนด command, sentinel, allowlist และรูปแบบรายงาน
- host กำหนดเวลา, credential, memory และขอบเขตสิทธิ์
- worktree dirty ตั้งแต่เริ่มให้ audit-only
- commit และ push ปิดเป็นค่าเริ่มต้น
- หากเปิด commit ต้อง stage เฉพาะ automation-owned paths และพิสูจน์ว่าไม่รวม diff เดิมของผู้ใช้
สถานะของ automation ควรรายงานเป็นข้อเท็จจริงแยกกัน ได้แก่ contract มีหรือไม่, scheduled job ถูกติดตั้งหรือไม่, รอบล่าสุดรันหรือไม่ และมีการ commit หรือ push จริงหรือไม่
ย้ายโปรเจกต์เดิมอย่างไรโดยไม่รบกวนงานที่กำลังรัน
มาตรฐานใหม่ไม่ใช่ใบอนุญาตให้ย้ายทุก repository พร้อมกัน การ migrate ต้องเริ่มจาก inventory ของแต่ละโปรเจกต์
- ตรวจ process, listener, test runner และ container ที่อ้างถึง project root
- บันทึก Git status และแยก diff เดิมออกจาก diff ของ migration
- ระบุ native runtime shape ว่าเป็น single app, monorepo หรือรูปแบบเฉพาะ
- เพิ่ม control plane โดยไม่ย้าย source, tests หรือ infra ในรอบแรก
- ตรวจ provider files ที่มีอยู่และเลือก adapter ที่จำเป็นจริง
- รัน audit แบบ read-only ก่อนเปิด cleanup
- หยุด migration เมื่อโปรเจกต์กำลังรัน, dirty มาก, ไม่มี rollback หรือ ownership ไม่ชัด
ในรอบที่ตรวจบทความนี้ พบโปรเจกต์หนึ่งกำลังรัน TypeScript และ Vitest พร้อม dirty files จำนวนมาก จึงถูกจัดเป็น skip-running ไม่มีการย้าย source หรือหยุด process นี่ไม่ใช่งานที่ทำไม่เสร็จ แต่เป็นการรักษา runtime และงานของผู้ใช้ตาม change-management ที่ถูกต้อง
บทวิเคราะห์ PAPAYIW
ประโยชน์ที่ลึกกว่าของ LLM Wiki คือการทำให้ทีมแยก ความจริง, ความเข้าใจ และคำสั่งปฏิบัติการ ออกจากกันได้ source บอกว่าอะไร, ทีมสรุปว่าอะไร และระบบอนุญาตให้ Agent ทำอะไร เป็นคำถามคนละข้อ
สำหรับงาน SEO และ content ความแตกต่างนี้ช่วยไม่ให้บทวิเคราะห์ใหม่เขียนทับข้อมูลต้นทาง ส่วนงาน software engineering จะช่วยไม่ให้ข้อความใน prompt ถูกเข้าใจผิดว่าเป็น enforcement จริง หาก cleanup เป็นเรื่องสำคัญ ต้องมี sentinel, containment และ test หาก skill ต้องใช้หลาย provider ต้องมี native path และ drift check ไม่ใช่เพียงเขียนว่า cross-provider
framework ที่ดีจึงไม่ได้วัดจากจำนวน hidden folders แต่วัดจากการตอบคำถามห้าข้อได้ชัดเจน
- อะไรคือ source of truth
- อะไรคือ local decision
- provider ใดอ่านไฟล์ใดจริง
- command ใดมีสิทธิ์ mutate อะไร
- ถ้า validation ล้มเหลว ระบบหยุดก่อนสร้างความเสียหายหรือไม่
เมื่อโครงสร้างตอบคำถามเหล่านี้ได้ Agent จะทำงานต่อจากหลักฐานเดิมได้ง่ายขึ้น และมนุษย์ยังตรวจสอบ แก้ไข หรือหยุดระบบได้ทุกจุด
คำถามที่พบบ่อย
AGENTS.md เป็นไฟล์ของ Codex เท่านั้นหรือไม่
Codex อ่านไฟล์นี้โดยตรง แต่ชื่อไฟล์สามารถใช้เป็น canonical contract กลางได้เมื่อ provider อื่นมี adapter ที่ถูกต้อง Claude Code ต้องใช้ CLAUDE.md import ส่วน Gemini CLI ใช้ GEMINI.md import หรือ config ที่รองรับ อย่าตีความว่าทุก provider โหลด AGENTS.md native เหมือนกัน
ต้องมี .antigravity folder หรือไม่
ไม่จำเป็นสำหรับโครงสร้างนี้ เอกสารปัจจุบันรองรับ workspace rules และ skills ที่ .agents/ การสร้าง .antigravity/ เพิ่มโดยไม่มี contract ที่ runtime ใช้จริงทำให้เกิด source of truth ซ้ำ
ทำไมไม่วาง management scripts ไว้ที่ root scripts
เพราะ root scripts/ ควรเป็นพื้นที่ของ product runtime เช่น build, deploy หรือ data import การวาง project control ใน tools/project-control/ ช่วยให้ ownership, audit และ migration ชัดเจนกว่า
demo คือ template ต้นฉบับหรือไม่
ไม่ใช่ demo ควรเป็น generated snapshot พร้อม provenance และ checksum ส่วน source ที่แก้ไขจริงมีแห่งเดียวใน framework วิธีนี้ป้องกัน demo กับ starter drift แยกจากกัน
สรุป
LLM Wiki เริ่มจาก raw source ที่คงสภาพเดิม มี maintained knowledge ที่อ้างกลับได้ และมี schema กำกับ ingest, query, lint, index กับ log เมื่อนำมารวมกับ Agent Project Starter ควรแยก framework ออกจาก generated project, เลือก runtime profile เดียว, ใช้ provider adapters ตามเอกสารจริง และบังคับ mutation ผ่าน project-control.json
ข้อสรุปที่สำคัญที่สุดคือ automation ที่ดีต้องรู้ว่าอะไร ห้ามแตะ ก่อนรู้ว่าจะลบอะไร และ starter ที่ดีต้องสร้างโปรเจกต์จาก allowlist ที่ตรวจผ่าน ไม่ใช่ clone ทุกอย่างที่บังเอิญอยู่ใน repository
แหล่งอ้างอิง
- LLM Wiki revision ที่ตรวจสอบ
- OpenAI Codex custom instructions with AGENTS.md
- Claude Code memory, CLAUDE.md และ AGENTS.md import
- Claude Code project skills
- Gemini CLI context with GEMINI.md
- Gemini CLI workspace skills
- Google Antigravity rules and workflows
- Google Antigravity skills
- The Making of Claude Code ฉบับแปลไทย

Senior AI SEO Strategist & CTO ของ BIQDADDY (ผู้ก่อตั้ง SERPert และ PAPAYIW) ประสบการณ์ด้าน SEM & Technical SEO กว่า 10 ปี มุ่งเน้นการนำเทคโนโลยี AI และ Automation มาประยุกต์ใช้งานจริงเพื่อปฏิรูปโครงสร้างองค์กร พร้อมขับเคลื่อนกลยุทธ์ SEO ยุคใหม่ (AISO/AEO/GEO) เพื่อสร้างผลลัพธ์ที่ยั่งยืนและแม่นยำที่สุด


