


เมื่อ AI มีตัวเลือกให้ “คิดมากขึ้น” หลายคนจึงเข้าใจโดยธรรมชาติว่า หากเพิ่มระดับการคิดให้สูงพอ Model ที่เล็กกว่าน่าจะทำงานแทน Model ที่เก่งกว่าได้
ความเข้าใจนี้ทำให้การออกแบบ workflow ผิดพลาดได้ง่าย โดยเฉพาะเมื่อทีมเริ่มใช้ AI กับงานที่มีผลต่อผลิตภัณฑ์ ลูกค้า หรือการตัดสินใจทางธุรกิจ
ก่อนอื่นต้องแยกสองสิ่งนี้ออกจากกันให้ชัดเจน: Model เป็นตัวกำหนดเพดานความสามารถ ส่วน Reasoning Effort เป็นตัวกำหนดทรัพยากรที่ให้ Model ใช้เพื่อวิเคราะห์โจทย์ การเพิ่ม effort อาจทำให้ Model เดิมตรวจทาน วางแผน และเชื่อมโยงข้อมูลได้ละเอียดขึ้น แต่ไม่ได้เปลี่ยน Model ให้กลายเป็นอีกรุ่นหนึ่ง
บทความนี้อธิบายความต่างดังกล่าวโดยอ้างอิงสถานะ GPT-5.6 ของ OpenAI ณ วันที่ 12 กรกฎาคม 2026 และชี้ให้เห็นจุดที่คนมักสับสนระหว่างตัวเลือกใน ChatGPT, Codex และ API
สารบัญเนื้อหา
แสดง
Model คือเพดานความสามารถ ไม่ใช่เพียงชื่อใน Model picker
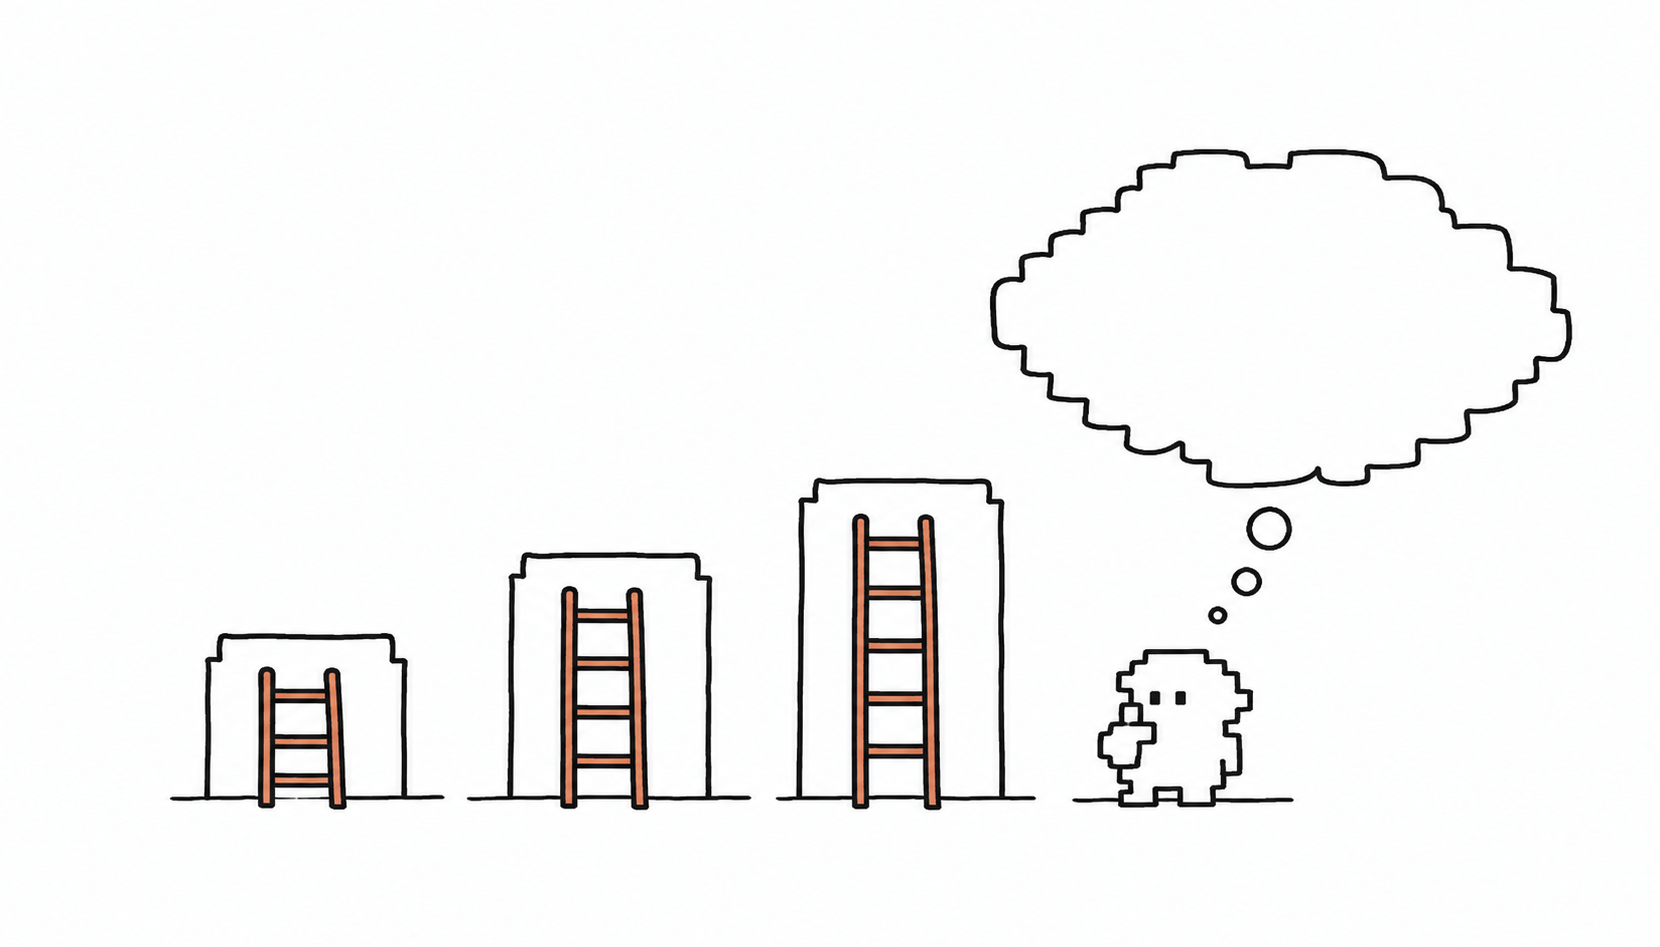
Model คือฐานความสามารถของระบบ ตั้งแต่วิธีรับมือกับโจทย์ที่คลุมเครือ ความสามารถในการใช้เครื่องมือ การเชื่อมโยงข้อมูล และคุณภาพของการวิเคราะห์งานเชิงเทคนิค
ในตระกูล GPT-5.6 OpenAI แยกบทบาทไว้ดังนี้
- Sol เป็น flagship Model ที่มี capability สูงสุดของตระกูล
- Terra เป็น Model ที่สมดุลระหว่าง capability, speed และ cost
- Luna เป็น Model ที่เร็วและต้นทุนต่ำที่สุดของตระกูล
หากงานต้องเข้าใจ codebase ที่ซับซ้อน ตัดสินใจจาก trade-off หลายชั้น หรือวิเคราะห์ปัญหาที่ผิดพลาดได้ยาก จุดเริ่มต้นควรเป็น Model ที่มี capability เหมาะกับโจทย์นั้นก่อน หากงานเป็นการจัดหมวดหมู่ข้อมูลตามเกณฑ์ที่ชัดเจนหรือการตอบคำถามที่มีขอบเขตจำกัด การใช้ Model ขนาดใหญ่ที่สุดอาจไม่ได้เพิ่มคุณภาพมากพอที่จะคุ้มกับต้นทุนและเวลารอ
นี่คือเหตุผลที่คำว่า “ให้คิดนานขึ้น” และ “ใช้ Model ที่เก่งขึ้น” ไม่ควรถูกใช้แทนกัน
Reasoning Effort คือระดับทรัพยากรสำหรับการวิเคราะห์
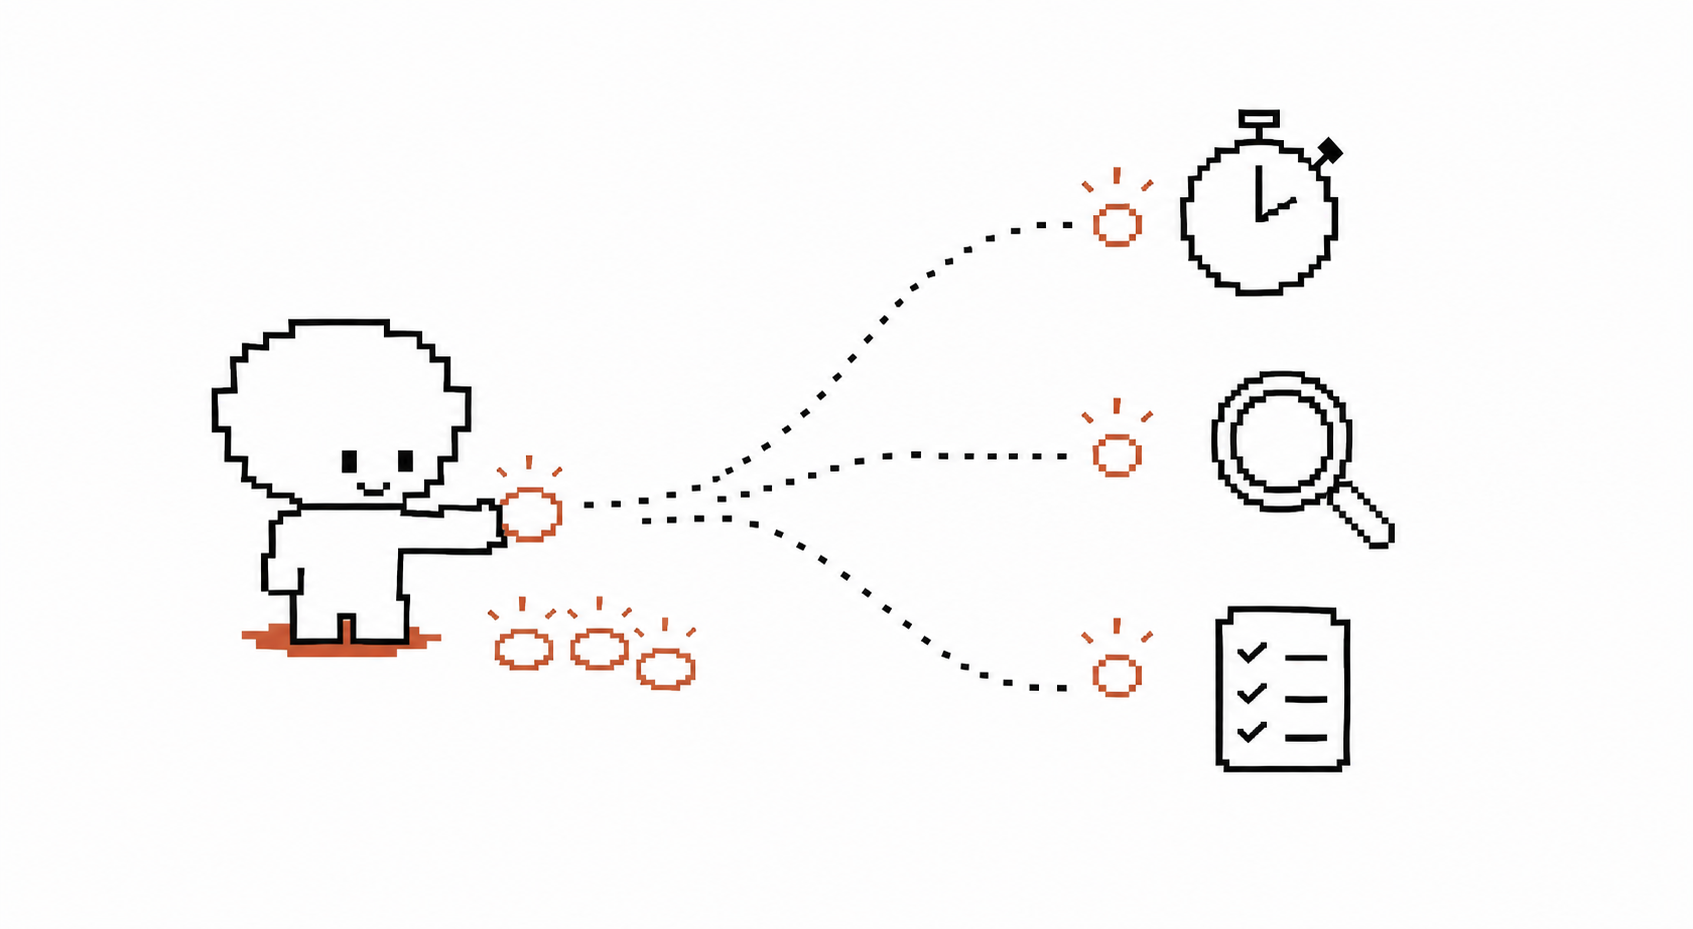
Reasoning Effort คือการตั้งค่าว่า Model ควรใช้ความพยายามมากน้อยเพียงใดในการวิเคราะห์ก่อนตอบ ในงานที่ซับซ้อนขึ้น การให้ Model ใช้เวลา reasoning เพิ่มขึ้นอาจช่วยให้ตรวจเงื่อนไข วางแผนเป็นลำดับ และทบทวนความเชื่อมโยงของข้อมูลได้มากขึ้น
แต่ effort ไม่ใช่ปุ่มเพิ่ม IQ
ลองเปรียบเทียบกับการทำงานของคน หากให้เวลานักวิเคราะห์เพิ่มขึ้น เขาอาจตรวจเอกสารได้ละเอียดขึ้นและลดความผิดพลาดจากการรีบทำงาน แต่เวลาที่มากขึ้นไม่ได้ทำให้คนที่ไม่มีความเชี่ยวชาญด้านความปลอดภัยไซเบอร์ กลายเป็นผู้เชี่ยวชาญด้านความปลอดภัยไซเบอร์ทันที
หลักเดียวกันใช้กับ AI
- Model กำหนดว่า AI มีความสามารถพื้นฐานแบบใด
- Reasoning Effort กำหนดว่า AI จะใช้ทรัพยากรเท่าใดในการทำงานภายในขอบเขตความสามารถนั้น
เพราะฉะนั้น คำว่า “Luna ที่คิดหนัก” ไม่ควรถูกสื่อความหมายว่าเท่ากับ Sol และ “Sol ที่ไม่ได้ใช้ reasoning สูงสุด” ก็ยังเป็น Sol ซึ่งมี capability พื้นฐานสำหรับรับมือกับโจทย์ยากกว่า
สิ่งที่ GPT-5.6 เปิดให้เห็นในแต่ละผลิตภัณฑ์
อีกจุดที่ทำให้เรื่องนี้สับสน คือผู้ใช้มักเห็นชื่อ reasoning level ในหน้าจอหนึ่ง แล้วคิดว่าชื่อเดียวกันใช้กับทุกผลิตภัณฑ์และทุก Model
ข้อมูลทางการของ OpenAI ณ วันที่ตรวจสอบระบุว่า standard ChatGPT conversation มีตัวเลือกดังนี้
- Instant ใช้ GPT-5.5 Instant สำหรับคำถามทั่วไปที่ต้องการความเร็ว
- Medium ใช้ GPT-5.6 Sol ในระดับ reasoning มาตรฐาน
- High ใช้ GPT-5.6 Sol ในระดับ reasoning ที่ขยายขึ้น
- Extra High ใช้ GPT-5.6 Sol ในระดับ reasoning สูงสุดที่ระบุไว้สำหรับ GPT-5.6 Sol
- Pro ใช้ GPT-5.6 Sol Pro สำหรับงานยากและ workflow ที่ใช้เวลานานกว่า
ใน standard ChatGPT conversation ผู้ใช้ไม่สามารถเลือก Terra หรือ Luna โดยตรง ขณะที่ Work in ChatGPT, Codex และ OpenAI API มีการเข้าถึง Sol, Terra และ Luna แตกต่างกันตามผลิตภัณฑ์และแผนบริการ OpenAI: GPT-5.6 in ChatGPT
นี่มีผลต่อการเขียนบทความหรือออกแบบคู่มืออย่างมาก เพราะเราไม่ควรยกตัวอย่าง configuration เช่น “Luna + Extra High ใน ChatGPT” หากเอกสารทางการไม่ได้ระบุว่าผู้ใช้เลือกชุดค่านี้ได้ใน interface นั้น
สำหรับการเปิดตัว GPT-5.6 OpenAI ยังประกาศ `max` reasoning effort เพื่อให้ Sol มีเวลา reasoning เชิงลึกมากขึ้น และ `ultra` mode ที่ใช้ subagents เพื่อเร่งงานซับซ้อนเกินขอบเขตของ single agent Previewing GPT-5.6 Sol
สิ่งที่ควรจำคือ `max`, `ultra`, Medium, High และ Extra High เป็นชื่อที่ต้องตีความตามผลิตภัณฑ์ สิทธิ์การเข้าถึง และเอกสารเวอร์ชันปัจจุบัน ไม่ใช่คำที่ควรนำมาจัดลำดับแทน capability tier ของ Sol, Terra และ Luna
เมื่อไรควรเพิ่ม Reasoning Effort
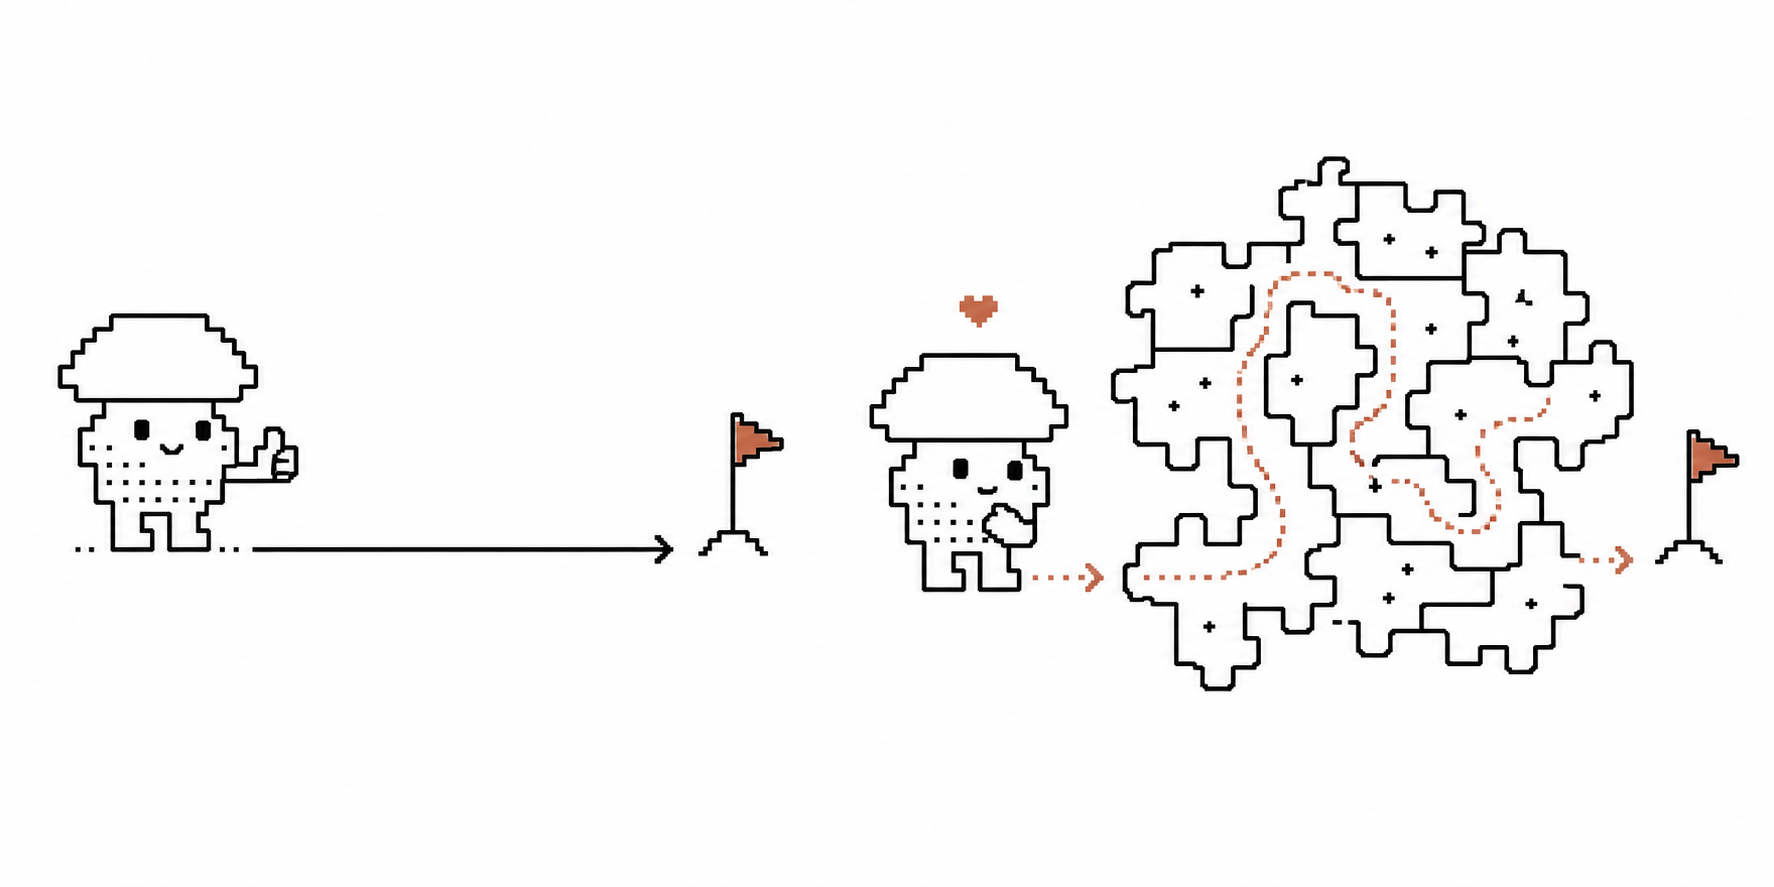
การเพิ่ม effort ควรมีเหตุผลเชิงงาน ไม่ใช่เพิ่มไว้ก่อนเพื่อให้คำตอบดูจริงจังขึ้น
งานที่มักคุ้มกับ effort สูงขึ้นมีลักษณะดังนี้
- มีเงื่อนไขหลายข้อที่ต้องตรวจพร้อมกัน
- ต้องเชื่อมโยงข้อมูลจากหลายไฟล์ หลายระบบ หรือหลายแหล่งอ้างอิง
- ต้องวางแผนเป็นลำดับ และการข้ามขั้นตอนอาจทำให้ข้อสรุปผิด
- ต้องเปรียบเทียบทางเลือกที่มี trade-off ชัดเจน
- มีความเสี่ยงสูงพอที่จะคุ้มกับเวลาและค่าใช้จ่ายในการตรวจทานเพิ่ม
ตัวอย่างเช่น การวิเคราะห์ว่าทำไมระบบหนึ่งจึงล้มเหลว อาจต้องอ่าน log, code, deployment history และเอกสาร architecture ร่วมกัน งานเช่นนี้ได้ประโยชน์จาก reasoning ที่มากขึ้น เพราะปัญหาไม่ได้อยู่ในข้อมูลชิ้นเดียว
ในทางกลับกัน งานต่อไปนี้มักไม่จำเป็นต้องเพิ่ม reasoning ให้สูงสุด
- แปลข้อความที่มีความหมายตรงไปตรงมา
- จัดหมวดหมู่ ticket ตาม taxonomy ที่กำหนดไว้แล้ว
- แยกชื่อ อีเมล หรือเลขอ้างอิงจากข้อมูลที่มีรูปแบบชัดเจน
- สร้างคำตอบจาก template ที่ผ่านการอนุมัติแล้ว
- ปรับ tone of voice ของข้อความที่มี intent ชัดเจน
สำหรับงานเหล่านี้ คุณภาพมักมาจาก schema, prompt, knowledge base และการทดสอบตัวอย่างมากกว่าการเพิ่ม reasoning ทุกครั้ง
การเลือกให้ถูกต้องต้องทำสองขั้นตอน
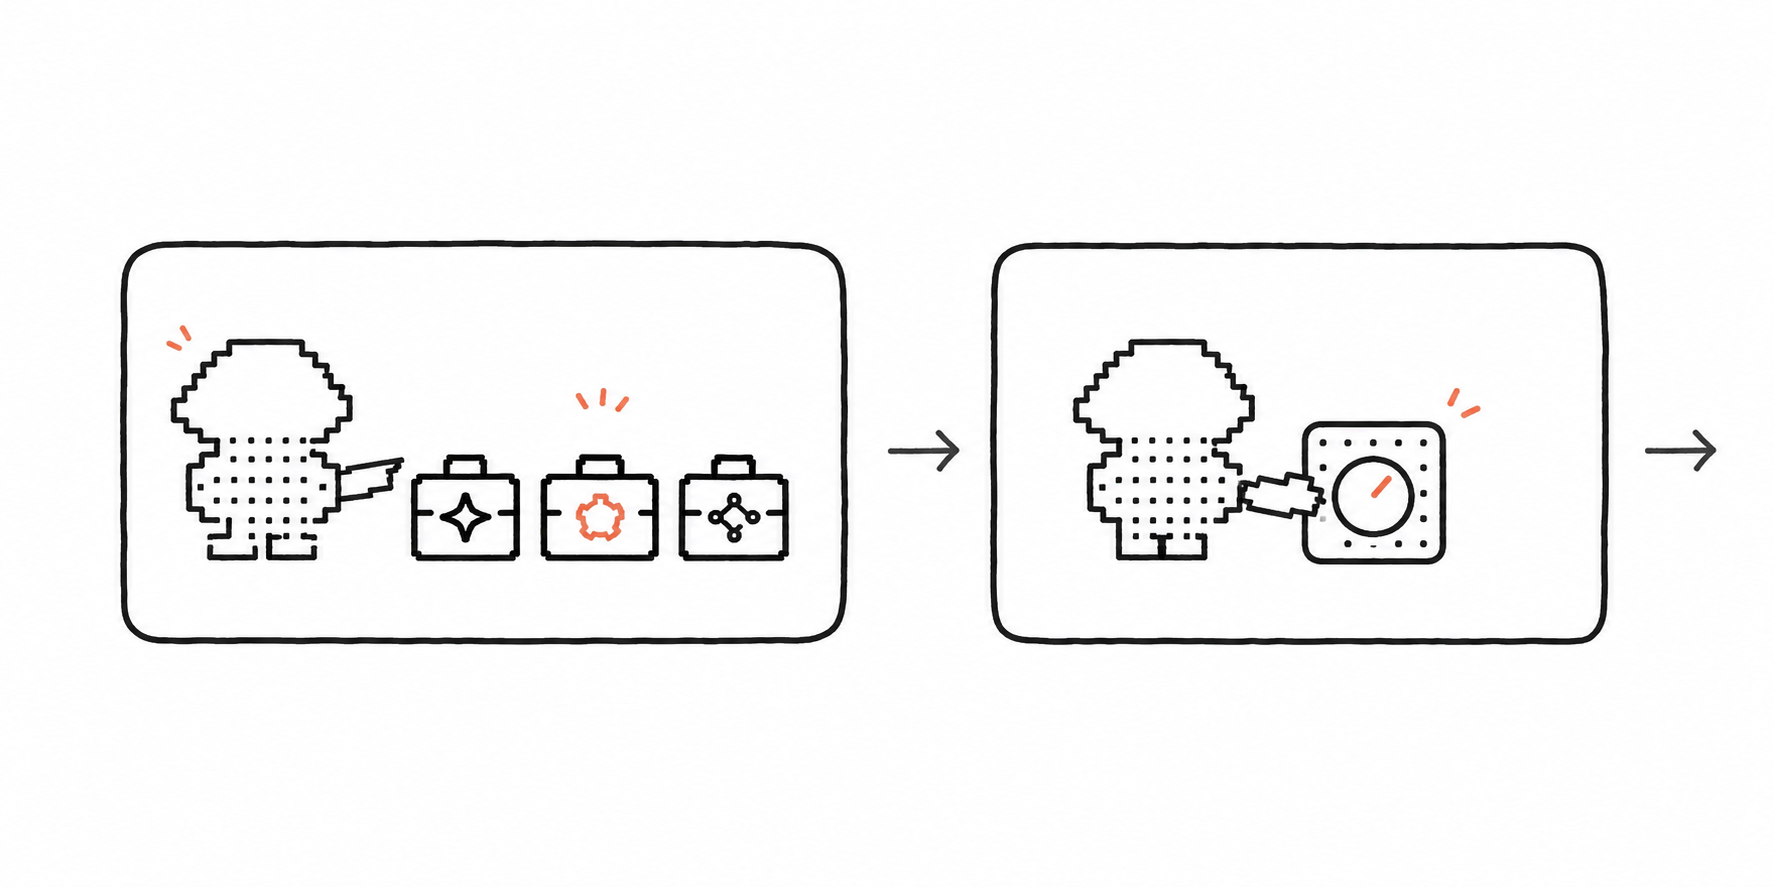
วิธีที่ปลอดภัยและคุ้มค่าที่สุดคือเลือก Model ก่อน แล้วจึงเลือก Reasoning Effort
ขั้นที่ 1: เลือก Model ตามความสามารถที่งานต้องใช้
ให้เริ่มจากคำถามต่อไปนี้
- งานนี้ต้องใช้ความเข้าใจเชิงเทคนิคหรือเหตุผลเชิงลึกตั้งแต่ต้นหรือไม่
- หากคำตอบผิด ผลกระทบต่อผู้ใช้ ระบบ หรืองบประมาณมากเพียงใด
- งานมีความคลุมเครือ หรือมีข้อจำกัดที่ต้องตีความมากเพียงใด
- งานนี้ต้องทำหนึ่งครั้งอย่างรอบคอบ หรือทำซ้ำในปริมาณมหาศาล
คำตอบจะช่วยให้เห็นว่าโจทย์ควรเริ่มจาก Sol, Terra หรือ Luna
ขั้นที่ 2: เลือก effort ตามความซับซ้อนของงานรอบนั้น
หลังเลือก Model แล้ว ค่อยประเมินว่างานรอบนี้ต้องให้ AI ใช้ทรัพยากรวิเคราะห์มากเพียงใด
- หากโจทย์ชัดเจน ทำซ้ำได้ และต้องการความเร็ว ให้ใช้ระดับ effort ที่เหมาะกับงานทั่วไป
- หากโจทย์มีหลายเงื่อนไข ต้องตรวจหลักฐาน หรือมี trade-off ให้เพิ่ม reasoning ตามความจำเป็น
- หากงานมีหลายส่วนและต้องประสานการวิเคราะห์ต่อเนื่อง จึงพิจารณา workflow ที่รองรับ `max` หรือ `ultra` ตามสิทธิ์และช่องทางที่ใช้งาน
การทำสองขั้นตอนนี้ช่วยแก้ความเข้าใจผิดสำคัญ คือการหวังให้ effort ที่สูงขึ้นชดเชยการเลือก Model ที่ไม่เหมาะกับงาน
ตัวอย่างการตัดสินใจที่ช่วยเห็นเส้นแบ่ง
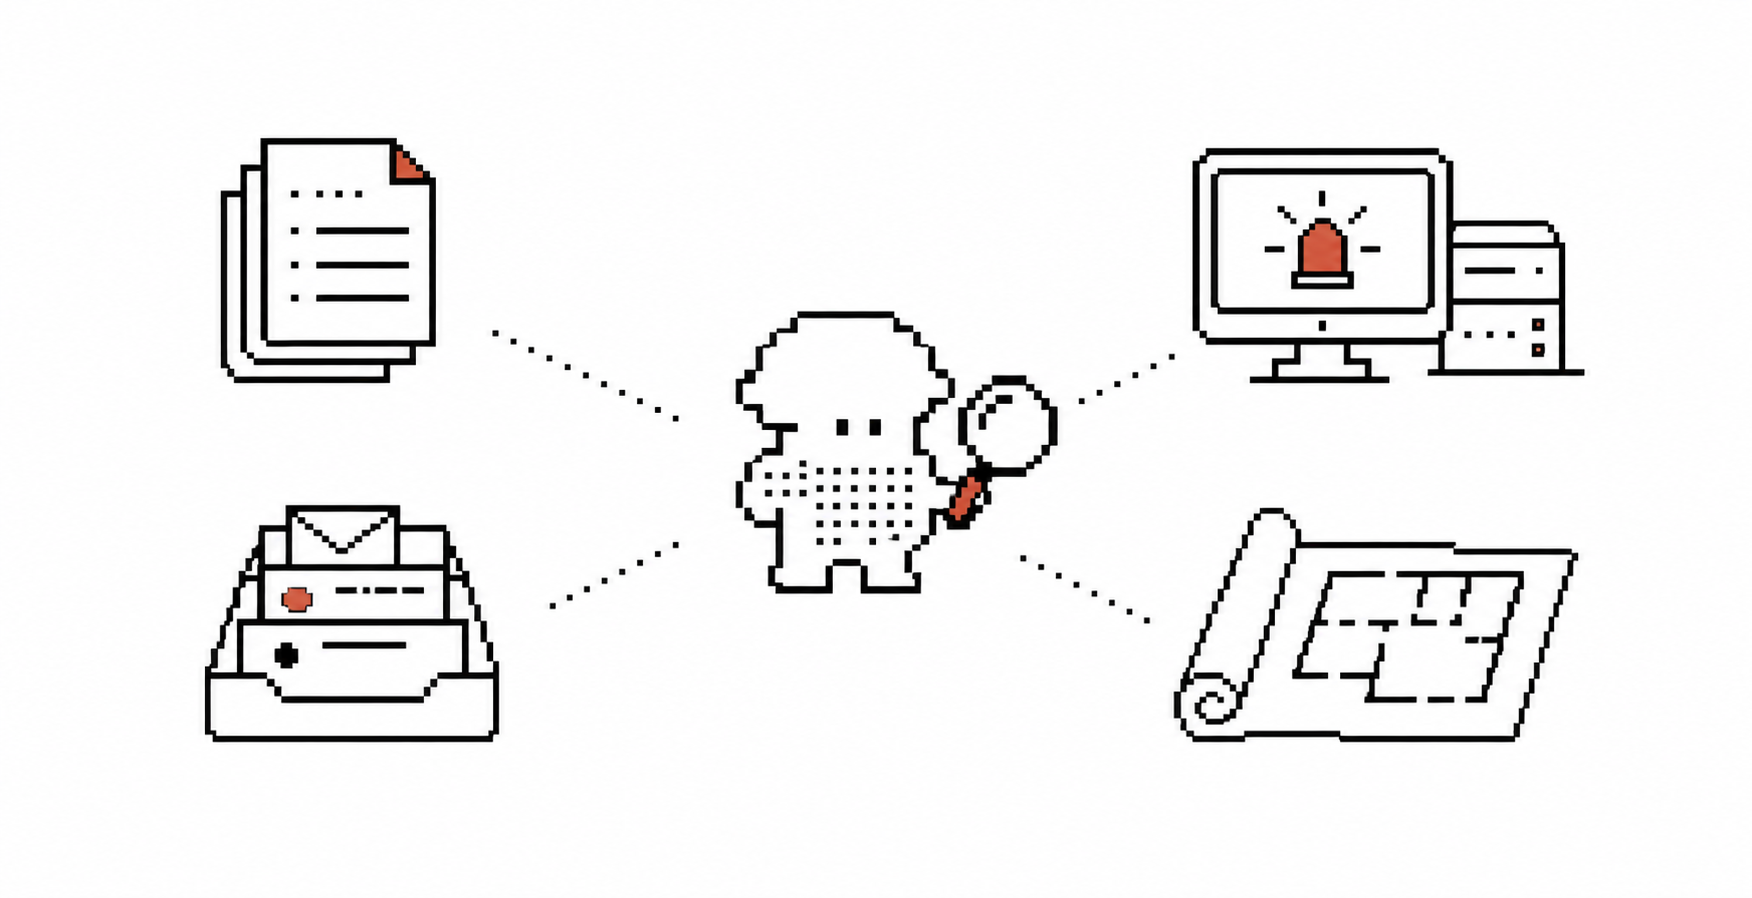
กรณีที่ 1: สรุปเอกสารการประชุมจำนวนมาก
หากเอกสารมีรูปแบบคล้ายกันและทีมต้องการสรุปเป็น template เดียวกัน งานนี้อาจเหมาะกับ Terra หรือ Luna ตามระดับการตีความที่ต้องใช้ การเพิ่ม effort เฉพาะเอกสารที่มีความขัดแย้งหรือมีประเด็นสำคัญ จะคุ้มกว่าการใช้ reasoning สูงสุดกับทุกไฟล์
กรณีที่ 2: วิเคราะห์เหตุการณ์ที่ระบบ production ผิดปกติ
โจทย์นี้อาจต้องเชื่อมโยงหลาย source และมีต้นทุนจากคำตอบที่ผิด ควรเริ่มจาก Sol แล้วเพิ่ม reasoning เมื่อจำเป็น แต่ยังต้องมีสิทธิ์การเข้าถึงที่จำกัด การยืนยันก่อน action และคนรับผิดชอบตรวจข้อเสนอของ Model
กรณีที่ 3: Chatbot สำหรับคัดกรองคำขอ
หากหน้าที่ของ Chatbot คือแยก intent และส่งเรื่องให้ทีมที่ถูกต้อง Luna หรือ Model ที่เน้น speed/cost มักเป็นจุดเริ่มต้นที่เหมาะกว่า สิ่งที่ควรลงทุนคือเกณฑ์ส่งต่อ, fallback, knowledge base และการวัดความแม่นยำ ไม่ใช่ reasoning สูงสุดในทุกข้อความ
กรณีที่ 4: วางแผนปรับ architecture ของระบบหลัก
งานนี้ไม่ควรเริ่มจากคำถามว่า “จะตั้ง reasoning ระดับไหน” แต่ต้องเริ่มจากการเลือก Sol เพราะโจทย์ต้องใช้ความสามารถในการวิเคราะห์ระบบและ trade-off เชิงเทคนิคตั้งแต่แรก จากนั้นจึงเลือกระดับ reasoning ให้สอดคล้องกับขนาดของ codebase จำนวนข้อจำกัด และความสำคัญของการตัดสินใจ
เหตุผลที่ effort สูงขึ้นต้องมาคู่กับการควบคุมที่ดีขึ้น
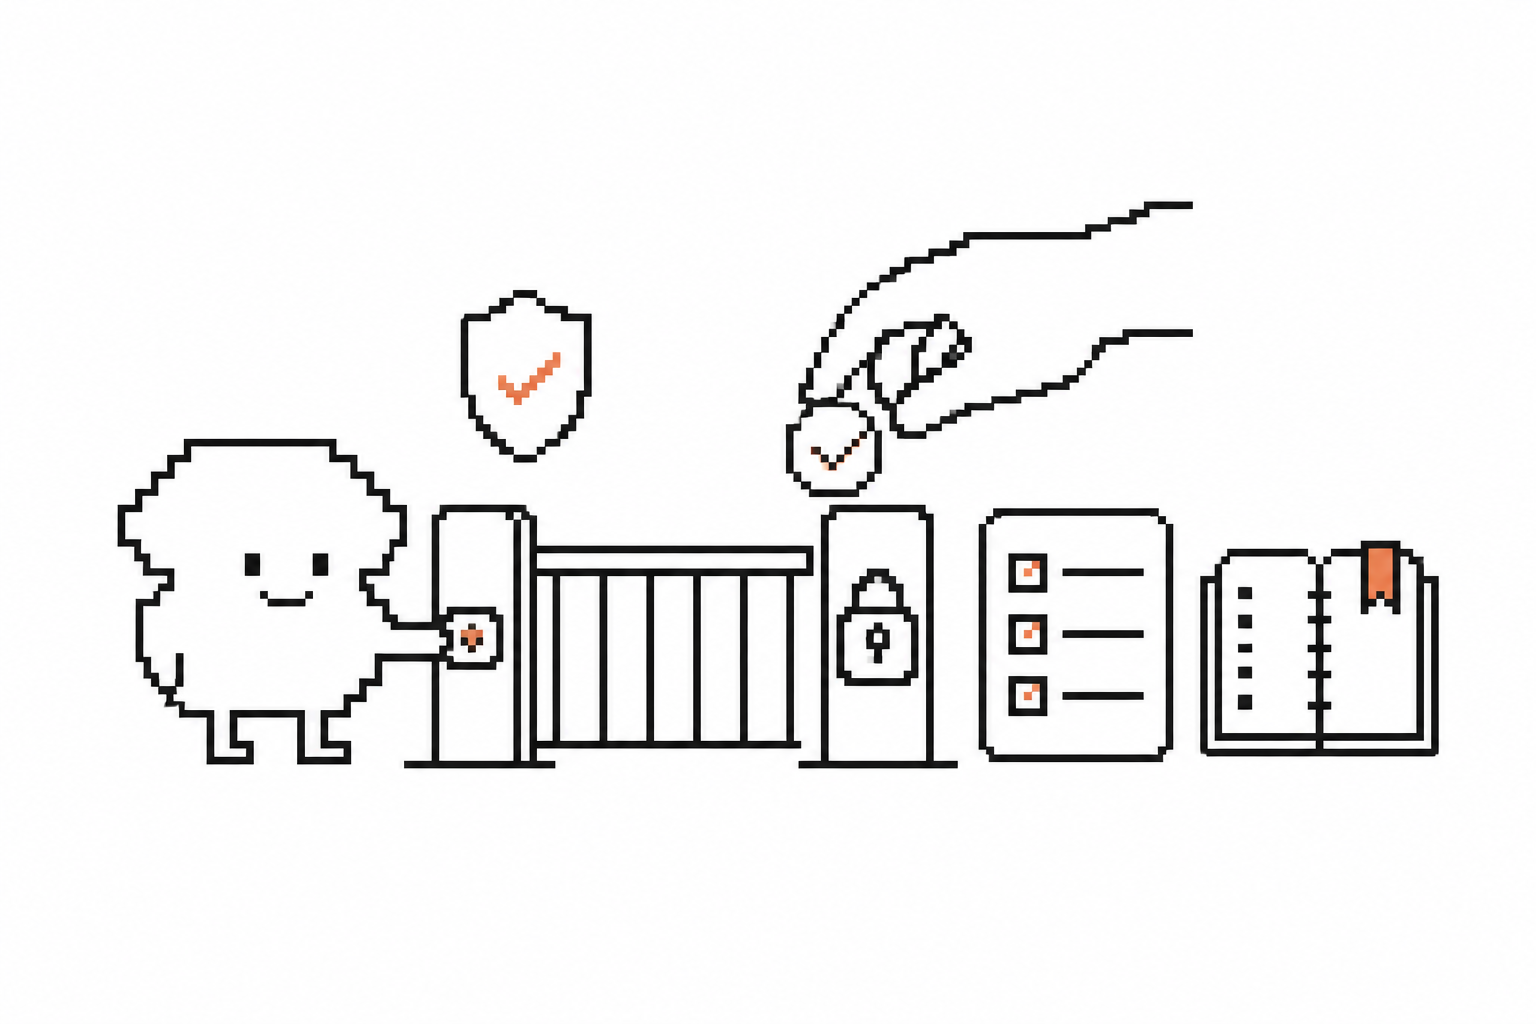
เมื่อ AI ใช้ reasoning มากขึ้นหรือทำงานแบบ agentic มากขึ้น ก็มีโอกาสเข้าถึง context, tool และ action มากขึ้นตาม workflow ที่ออกแบบไว้ สิ่งที่ทีมควรเพิ่มจึงไม่ใช่เพียงงบประมาณสำหรับ token แต่รวมถึงการควบคุมด้วย
- กำหนดขอบเขตของ tool และข้อมูลที่ Model เข้าถึงได้
- ให้มี approval ก่อน action ที่แก้ไขหรือลบข้อมูล
- เก็บ log ที่เพียงพอสำหรับตรวจสอบเหตุผลและผลลัพธ์
- ทดสอบ workflow ด้วยกรณีผิดปกติ ไม่ใช่เฉพาะ happy path
- มี fallback ที่ส่งต่อให้คนเมื่อ Model ไม่มั่นใจหรือข้อมูลไม่พอ
System Card ของ GPT-5.6 เน้นว่าความสามารถแบบ agentic ต้องมาคู่กับ safeguards และการกำกับใช้งาน การออกแบบ human review จึงไม่ใช่สัญญาณว่าทีมไม่เชื่อ AI แต่เป็นส่วนหนึ่งของระบบที่รับผิดชอบ GPT-5.6 Preview System Card
บทวิเคราะห์ PAPAYIW: การตั้งค่า AI กำลังกลายเป็นทักษะออกแบบงาน
ในช่วงแรกของ Generative AI คนมักเลือกเครื่องมือด้วยคำถามว่า Model ไหนตอบเก่งที่สุด แต่เมื่อ Model เริ่มเข้าไปทำงานเป็นส่วนหนึ่งของ product และ workflow คำถามที่สำคัญกว่าคือ เราออกแบบให้ Model ไหนรับผิดชอบงานส่วนใด และเมื่อไรระบบควรใช้ทรัพยากรเพิ่ม
นี่คือจุดที่ Model selection และ Reasoning Effort มีความหมายต่อทีม SEO, AEO และ GEO เช่นกัน การทำ content operation ที่ดีไม่จำเป็นต้องใช้ reasoning สูงสุดกับทุก brief แต่ต้องรู้ว่าขั้นไหนเป็นงานจัดระเบียบ ขั้นไหนเป็นงานสังเคราะห์ และขั้นไหนเป็นงานที่ต้องอาศัยวิจารณญาณของมนุษย์
เมื่อแยก Model ออกจาก effort ได้ชัดเจน ทีมจะเลิกมอง AI เป็นปุ่มวิเศษ แล้วเริ่มมองมันเป็นระบบงานที่ต้องมี routing, guardrails, quality checks และตัวชี้วัดของตัวเอง
สรุป
Reasoning Effort ช่วยให้ Model ใช้ทรัพยากรวิเคราะห์โจทย์มากขึ้น แต่ไม่ได้เปลี่ยนเพดานความสามารถของ Model
- เลือก Model จากความยาก ความเสี่ยง และประเภทของงาน
- เลือก Reasoning Effort จากจำนวนเงื่อนไข ความจำเป็นในการตรวจทาน และทรัพยากรที่คุ้มจะใช้
- ตรวจเสมอว่าตัวเลือกใดมีอยู่จริงใน ChatGPT, Codex, Work หรือ API ที่ทีมกำลังใช้
- ใช้ effort สูงขึ้นพร้อมกับ guardrails, approval และ human review ที่เหมาะกับผลกระทบของงาน
เมื่อใช้หลักนี้ การตั้งค่า AI จะไม่ใช่การเลือกให้ “คิดมากที่สุด” แต่เป็นการเลือกให้คิดในระดับที่เหมาะกับคุณภาพ ความเร็ว และต้นทุนของงานจริง
แหล่งอ้างอิง

Senior AI SEO Strategist & CTO ของ BIQDADDY (ผู้ก่อตั้ง SERPert และ PAPAYIW) ประสบการณ์ด้าน SEM & Technical SEO กว่า 10 ปี มุ่งเน้นการนำเทคโนโลยี AI และ Automation มาประยุกต์ใช้งานจริงเพื่อปฏิรูปโครงสร้างองค์กร พร้อมขับเคลื่อนกลยุทธ์ SEO ยุคใหม่ (AISO/AEO/GEO) เพื่อสร้างผลลัพธ์ที่ยั่งยืนและแม่นยำที่สุด


